low, medium, auto 동작과 이미지 가격, 이전 일정, Arena 근거를 공식 자료로 정리했습니다.
기존 quality 모델 이름은 2026년 11월 2일 종료되고 Image 2.0 low로 연결됩니다.
빠른 요약
핵심 요약
- 기존 quality 모델 이름은 2026년 11월 2일 종료되고 Image 2.0 low로 연결됩니다.
- 출력은 장당 0.04~0.08달러이며 입력 이미지는 장당 0.01달러입니다. 재시도와 승인율도 계산해야 합니다.
- X AI가 인용한 Arena 순위는 2026년 8월 7일 시점 자료입니다. 캐릭터 일관성, 글자, 편집 보존은 자체 프롬프트로 검증해야 합니다.
2026년 11월 2일에 바뀌는 점
기존 quality 모델 이름은 2026년 11월 2일 종료되고 Image 2.0 low로 연결됩니다.
이전은 생성과 편집 엔드포인트 모두에 적용되며 grok-imagine-image-pro도 기존 리디렉션을 따라 Image 2.0 low로 이동합니다. 새 모델은 명시적 quality, 최대 5개 입력 이미지, 21:9와 5:2 비율을 지원합니다. 대표 작업 일부를 명시적 2.0 이름으로 먼저 전환하고 반환 모델을 기록하며 롤백을 유지해야 합니다. HTTP 성공만으로 문자, 인물 정체성, 편집 결과가 납품 가능하다는 뜻은 아닙니다.
Low, medium, auto는 워크플로 선택
low는 구성, 색, 실루엣을 저비용으로 선별할 때, medium은 작은 글자, 얼굴, 표면 세부와 정밀 편집을 검토할 때 적합합니다. auto는 현재 생성에 low, 편집에 medium을 쓰지만 변경 가능한 서비스 정책입니다. 1K low로 약한 아이디어를 거르고 소수 후보만 2K medium으로 올리면 비용을 제어할 수 있습니다.
| Quality | Current behavior | Use |
|---|---|---|
| low | Lower cost | Exploration |
| medium | More detail | Review and precise edits |
| auto | Low generation; medium editing | Managed default |
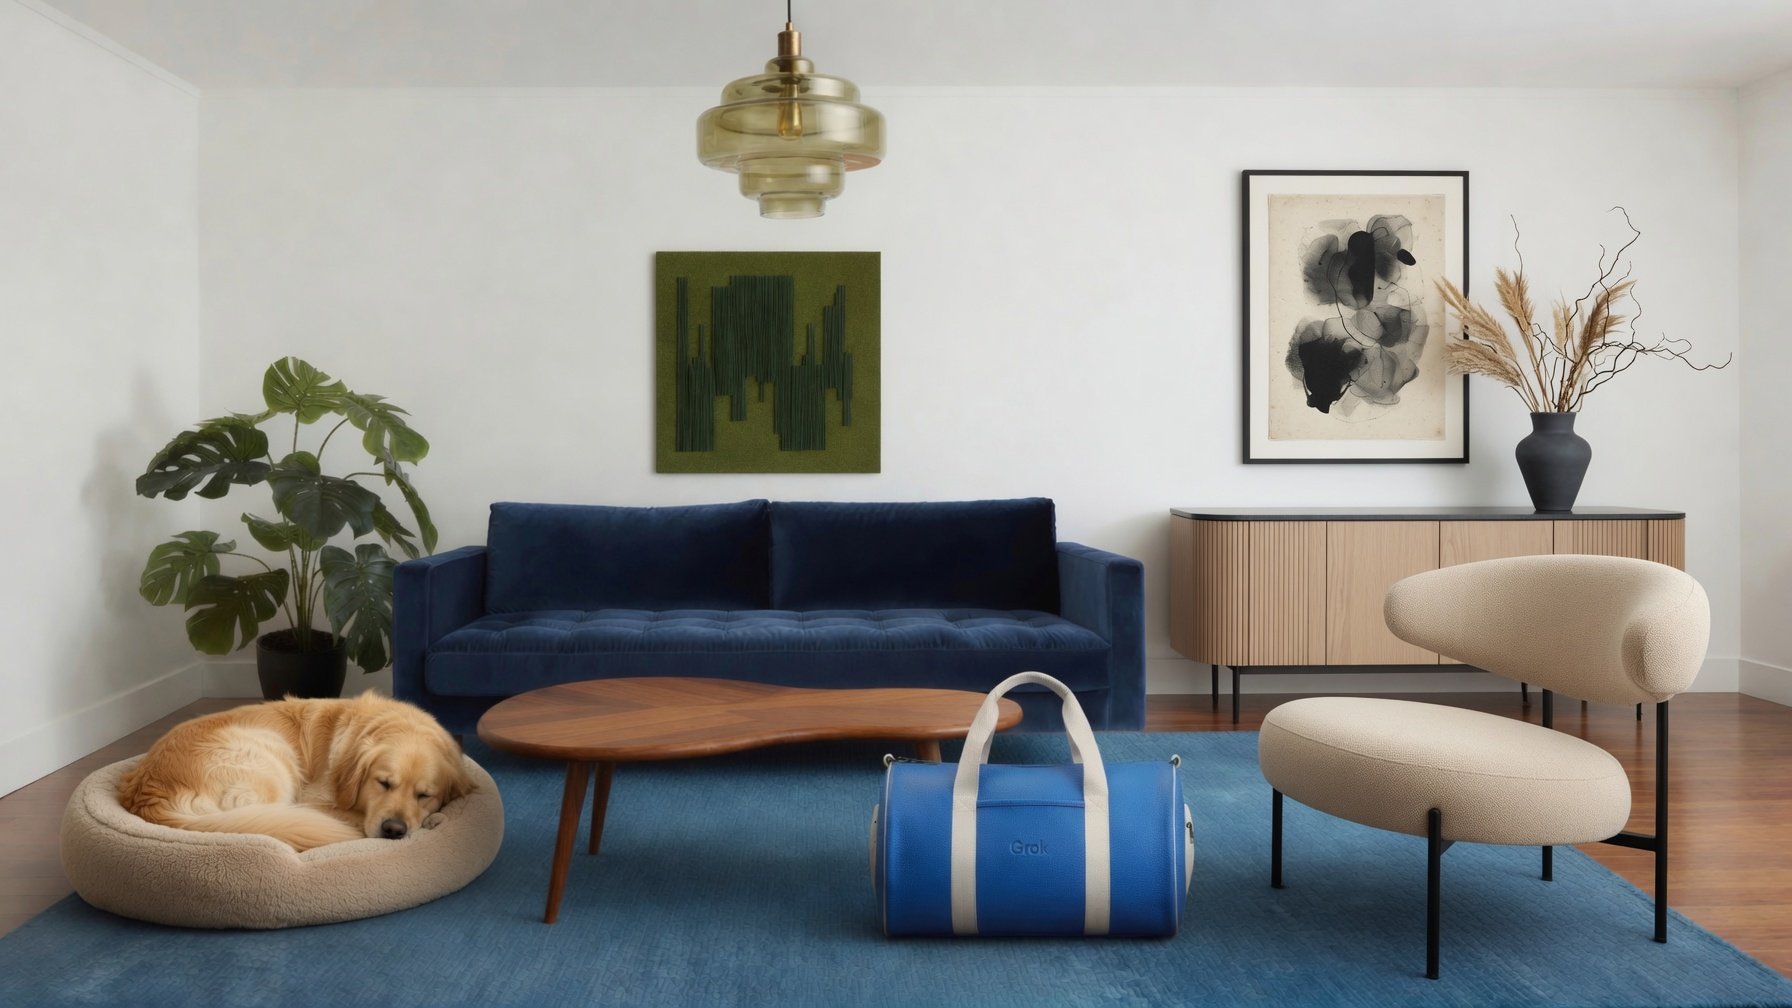
Grok Imagine Image 2.0 가격과 실효 비용
출력은 장당 0.04~0.08달러이며 입력 이미지는 장당 0.01달러입니다. 재시도와 승인율도 계산해야 합니다.
요청 단가는 승인된 자산의 비용이 아닙니다. 참조 3장과 1.5K medium 출력 한 번은 0.10달러이며 평균 2.5회가 필요하면 승인 결과당 약 0.25달러입니다. 요청 비용, 재시도, 검토와 수정 시간, 거절 이유를 기록하고 usage.cost_in_usd_ticks로 청구액과 연결해야 합니다.
| Resolution | Low | Medium |
|---|---|---|
| 1K | $0.04 | $0.06 |
| 1.5K | $0.05 | $0.07 |
| 2K | $0.06 | $0.08 |
Arena 원본 근거 읽기
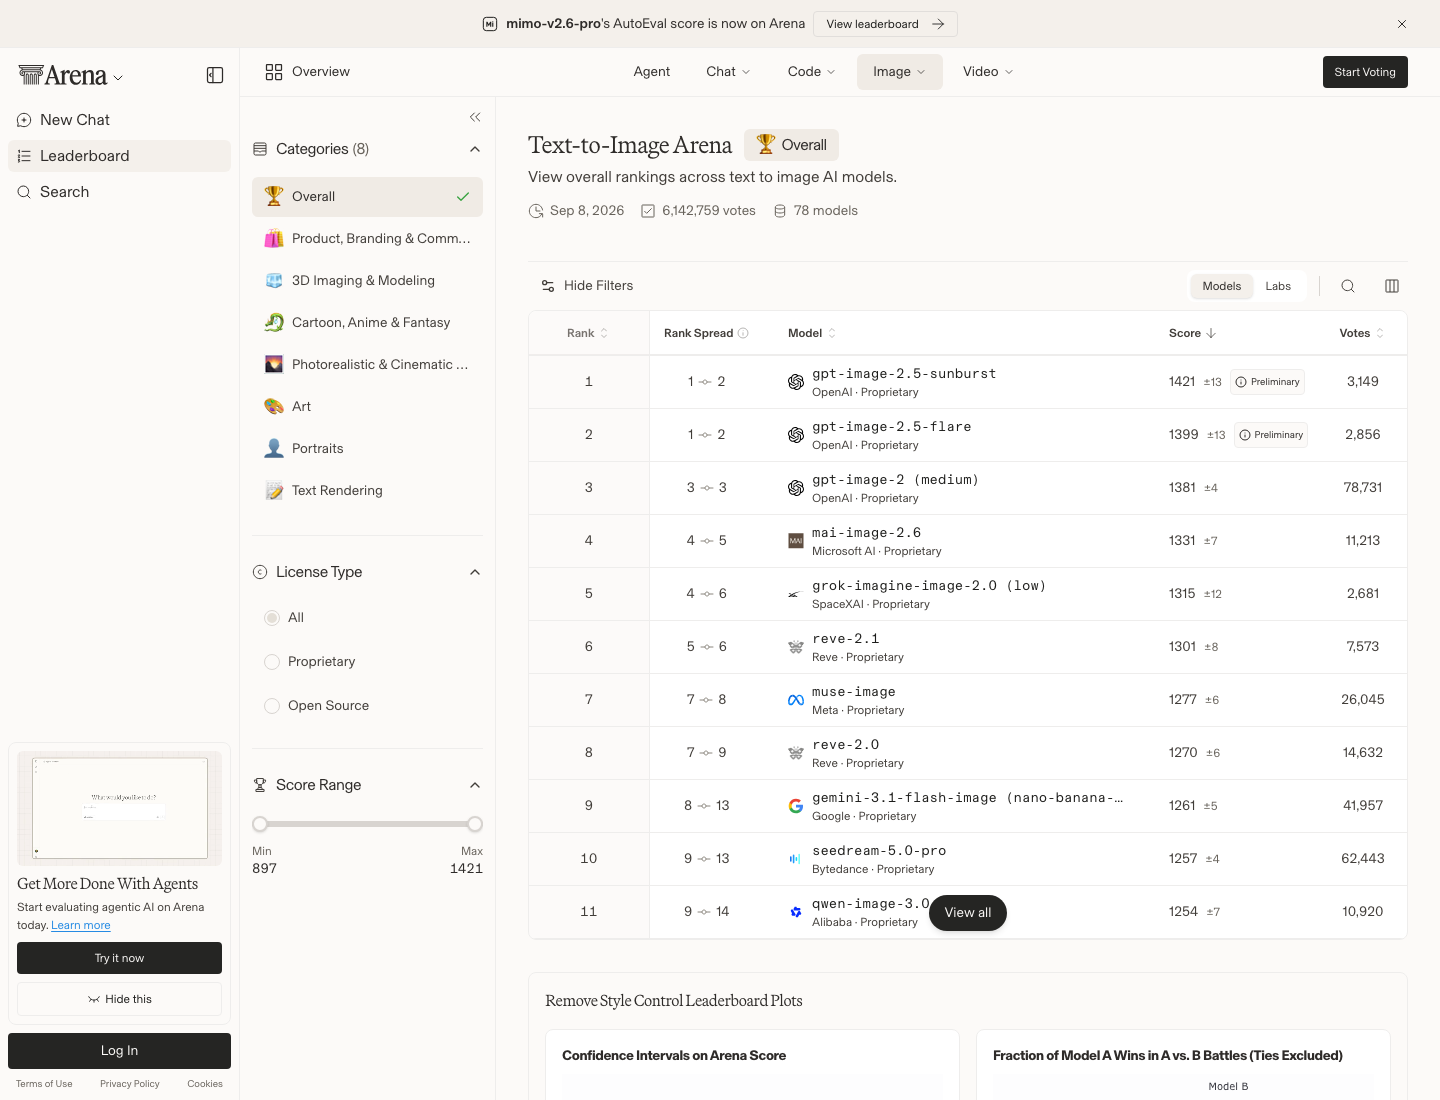
X AI가 인용한 Arena 순위는 2026년 8월 7일 시점 자료입니다. 캐릭터 일관성, 글자, 편집 보존은 자체 프롬프트로 검증해야 합니다.
X AI가 8월 7일 인용한 순위는 영구 결론이 아닙니다. 9월 22일 캡처한 Arena 공식 화면은 9월 8일 자료를 표시했으며 grok-imagine-image-2.0 (low)는 5위, 범위 4–6, 1315 ±12, 2,681표였습니다. Arena는 변하는 익명 선호를 측정하지만 비용, 지연, 라이선스, 반복 편집 후 인물 안정성은 측정하지 않습니다.
- 기존 quality 모델 이름은 2026년 11월 2일 종료되고 Image 2.0 low로 연결됩니다.
- 출력은 장당 0.04~0.08달러이며 입력 이미지는 장당 0.01달러입니다. 재시도와 승인율도 계산해야 합니다.
- X AI가 인용한 Arena 순위는 2026년 8월 7일 시점 자료입니다. 캐릭터 일관성, 글자, 편집 보존은 자체 프롬프트로 검증해야 합니다.
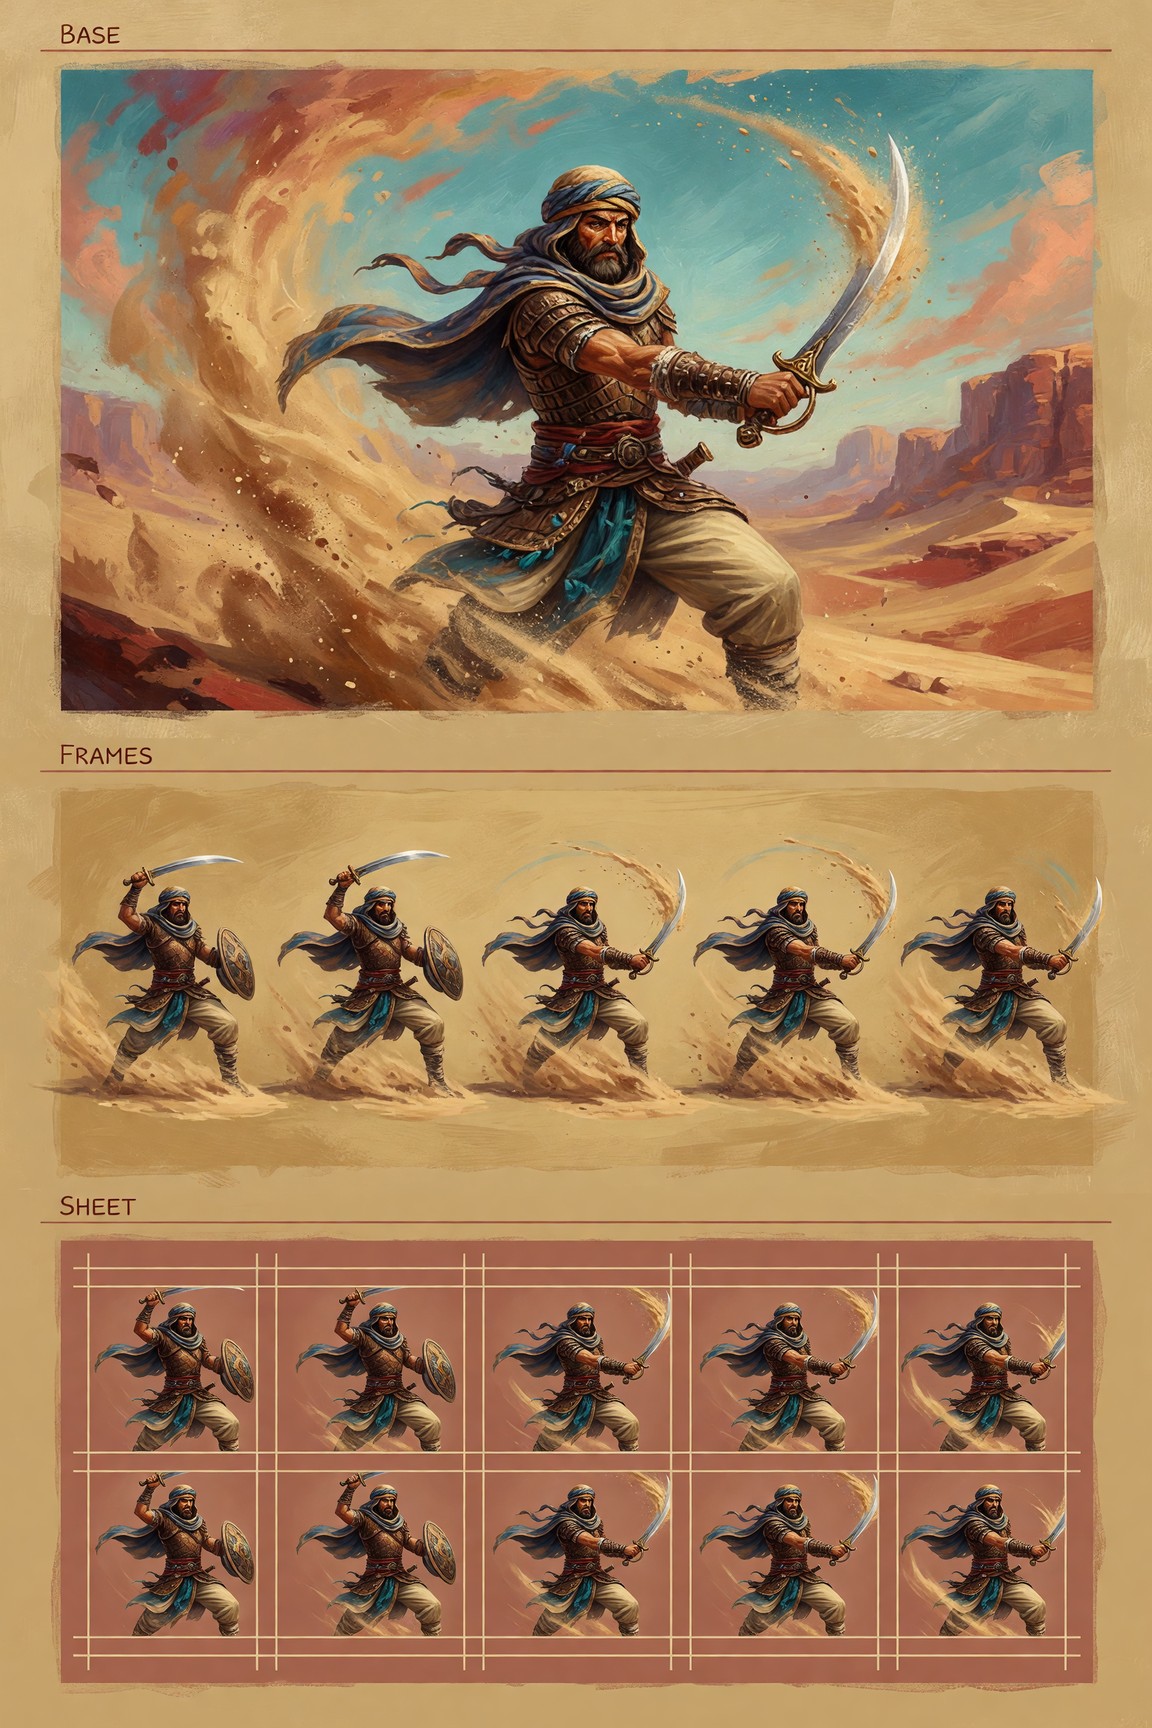
공식 샘플이 보여 주는 것과 보여 주지 못하는 것
X AI 갤러리는 타이포그래피, 편집, 다중 참조, 스마트 리사이즈, Character Sprite를 보여 주어 테스트 범주 설계에 유용합니다. 그러나 선별된 공급자 샘플이며 평균 성공률은 아닙니다. 일반 프롬프트, 어려운 비율, 반복 인물, 작은 다국어 문자, 투명 배경, 선택 밖 영역을 유지해야 하는 편집을 포함하고 실제 게임 크기로 확인하세요.
재현 가능한 모델 평가 계획
새 인물, 같은 인물의 다른 장면, 의상 부분 편집, 텍스트 UI, 소품 시트, 좁은 이미지를 넓게 확장하는 작업처럼 실제 납품물을 시험합니다. 공급자 이름을 가리고 순서를 섞어 지시 준수, 구성, 문자, 정체성, 편집 보존, 결함, 정리 비용을 따로 평가합니다. 결론은 단일 우승자가 아니라 작업별 라우팅 정책이어야 합니다.
- 프롬프트, 참조, 사용 가능한 seed, 승인 기준을 고정합니다.
- low부터 실행하고 유효한 후보만 medium으로 올립니다.
- 반환 모델, usage.cost_in_usd_ticks, 지연, 재시도를 기록합니다.
- 문자, 인물 정체성, 부분 편집, 비율, 5장 합성을 분리해 확인합니다.
- 게시, 구매, 주요 모델 업데이트 때 가격과 Arena를 다시 확인합니다.
영구 우승자가 아니라 품질 정책 선택
넓은 탐색은 low, 세부나 편집이 중요한 소수 작업은 medium, 예산과 회귀 비교가 중요하면 명시 설정이 실용적입니다. 11월 2일 전에 2.0으로 명시적으로 이전하고 반환 모델을 확인하며 자체 작업의 승인 결과당 비용을 비교하세요. Arena와 공식 샘플은 시험 범위를 줄이고 재현 가능한 내부 기록이 운영 투입을 결정합니다.
자주 묻는 질문
Grok Imagine Image 2.0 이전: 품질 설정과 비용
low, medium, auto 동작과 이미지 가격, 이전 일정, Arena 근거를 공식 자료로 정리했습니다.
Auto
기존 quality 모델 이름은 2026년 11월 2일 종료되고 Image 2.0 low로 연결됩니다.
Arena
X AI가 인용한 Arena 순위는 2026년 8월 7일 시점 자료입니다. 캐릭터 일관성, 글자, 편집 보존은 자체 프롬프트로 검증해야 합니다.
low와 medium 중 무엇을 써야 하나요?
구성과 방향 탐색에는 low를 쓰고 문자, 얼굴, 세부, 편집 보존이 승인에 영향을 주는 후보만 medium으로 올리세요.
이전 테스트에서 무엇을 측정해야 하나요?
지시 준수, 인물 일관성, 문자, 편집 보존, 결함, 지연, 재시도, 검토 시간, 승인 자산당 비용을 측정합니다.
공식 샘플이 평균 품질을 뜻하나요?
아닙니다. 제품 목표와 테스트 설계에는 도움이 되지만 선별 출력이며 무작위 성공률이나 실패 분포를 제공하지 않습니다.
출처 및 추가 자료
- X AI Image 2.0 migration guide
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
- X AI Grok Imagine Image 2.0 model page
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
- X AI API pricing
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
- X AI Imagine Image 2.0 launch
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
- X AI cost tracking
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
- Arena Text-to-Image leaderboard
모델 동작, 가격, 이전 일정 또는 게임 기능을 확인한 공식 자료. 2026년 9월 20일 확인.
다음 단계