Geprüfter Leitfaden zu low, medium, auto, Bildpreisen, Migration und Arena-Belegen.
Der alte quality-Modellname endet am 2. November 2026 und wird auf Image 2.0 low geleitet.
Kurzüberblick
Das Wichtigste
- Der alte quality-Modellname endet am 2. November 2026 und wird auf Image 2.0 low geleitet.
- Ausgaben kosten 0,04 bis 0,08 US-Dollar; jedes Eingabebild kostet weitere 0,01 US-Dollar. Wiederholungen und Freigabequote gehören in die Rechnung.
- Der von X AI zitierte Arena-Rang ist eine Momentaufnahme vom 7. August 2026. Identität, Text und Bearbeitungstreue müssen mit eigenen Prompts geprüft werden.
Was sich am 2. November 2026 ändert
Der alte quality-Modellname endet am 2. November 2026 und wird auf Image 2.0 low geleitet.
Die Migration betrifft Generierung und Bearbeitung; auch grok-imagine-image-pro folgt seiner bestehenden Weiterleitung zu Image 2.0 low. Das neue Modell akzeptiert ein explizites quality, bis zu fünf Eingabebilder sowie 21:9 und 5:2. Leite zuerst eine repräsentative Teilmenge an den ausdrücklichen 2.0-Namen, protokolliere das zurückgegebene Modell und behalte einen Rollback. Ein erfolgreicher HTTP-Aufruf belegt keine lieferfähigen Texte, Identitäten oder Bearbeitungen.
Low, medium und auto sind Workflow-Entscheidungen
low eignet sich zum günstigen Filtern von Komposition, Farbe und Silhouette; medium für kleine Schrift, Gesichter, Oberflächen und präzise Bearbeitungen. auto nutzt derzeit low für Generierung und medium für Bearbeitung, bleibt aber eine veränderliche Servicerichtlinie. Verwirf schwache Ideen in 1K low und reserviere 2K medium für wenige stabile Kandidaten.
| Quality | Current behavior | Use |
|---|---|---|
| low | Lower cost | Exploration |
| medium | More detail | Review and precise edits |
| auto | Low generation; medium editing | Managed default |
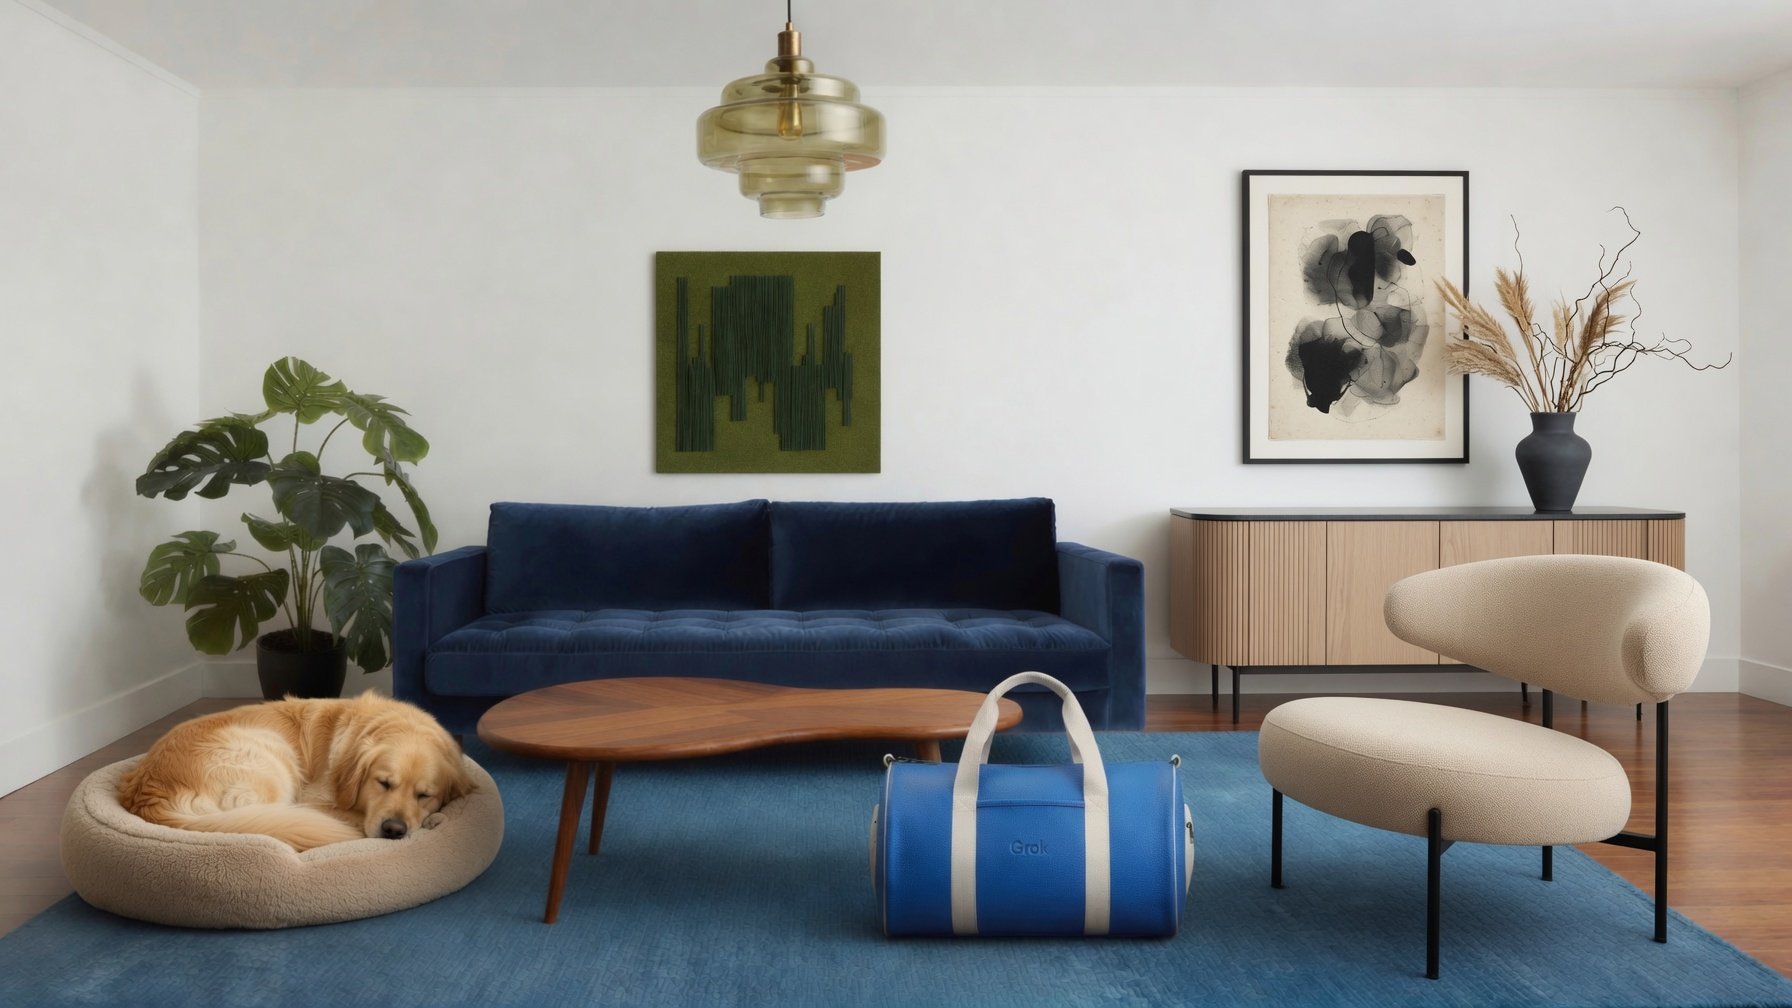
Preis und effektive Kosten von Grok Imagine Image 2.0
Ausgaben kosten 0,04 bis 0,08 US-Dollar; jedes Eingabebild kostet weitere 0,01 US-Dollar. Wiederholungen und Freigabequote gehören in die Rechnung.
Der Anfragepreis ist nicht der Preis eines freigegebenen Assets. Drei Referenzen plus eine 1.5K-medium-Ausgabe kosten 0,10 US-Dollar; bei durchschnittlich 2,5 Versuchen sind es etwa 0,25 US-Dollar pro akzeptiertem Ergebnis. Erfasse Kosten, Wiederholungen, Prüf- und Korrekturzeit sowie Ablehnungsgründe und verbinde die Rechnung über usage.cost_in_usd_ticks.
| Resolution | Low | Medium |
|---|---|---|
| 1K | $0.04 | $0.06 |
| 1.5K | $0.05 | $0.07 |
| 2K | $0.06 | $0.08 |
Die ursprüngliche Arena-Evidenz lesen
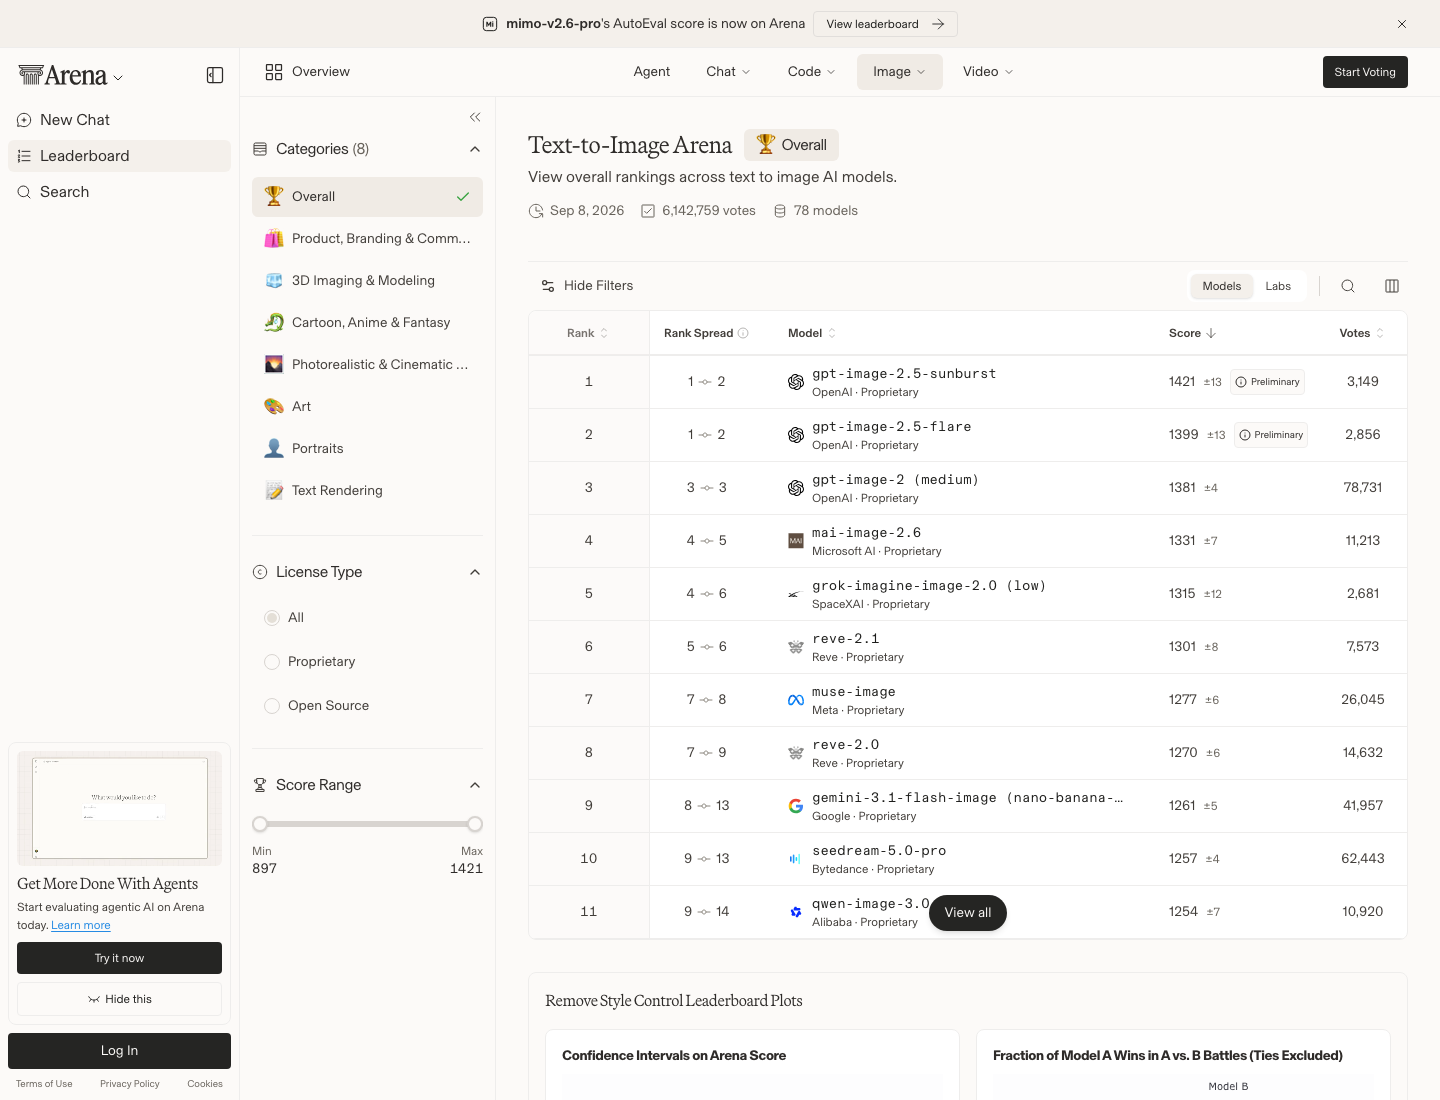
Der von X AI zitierte Arena-Rang ist eine Momentaufnahme vom 7. August 2026. Identität, Text und Bearbeitungstreue müssen mit eigenen Prompts geprüft werden.
Der von X AI am 7. August zitierte Rang ist nicht dauerhaft. Der offizielle Screenshot vom 22. September zeigte Daten vom 8. September: grok-imagine-image-2.0 (low) lag auf Rang 5, Rangbereich 4–6, 1315 ±12 und 2.681 Stimmen. Arena misst wechselnde anonyme Präferenz, nicht Kosten, Latenz, Rechteprozesse oder Stabilität nach vielen Figurenbearbeitungen.
- Der alte quality-Modellname endet am 2. November 2026 und wird auf Image 2.0 low geleitet.
- Ausgaben kosten 0,04 bis 0,08 US-Dollar; jedes Eingabebild kostet weitere 0,01 US-Dollar. Wiederholungen und Freigabequote gehören in die Rechnung.
- Der von X AI zitierte Arena-Rang ist eine Momentaufnahme vom 7. August 2026. Identität, Text und Bearbeitungstreue müssen mit eigenen Prompts geprüft werden.
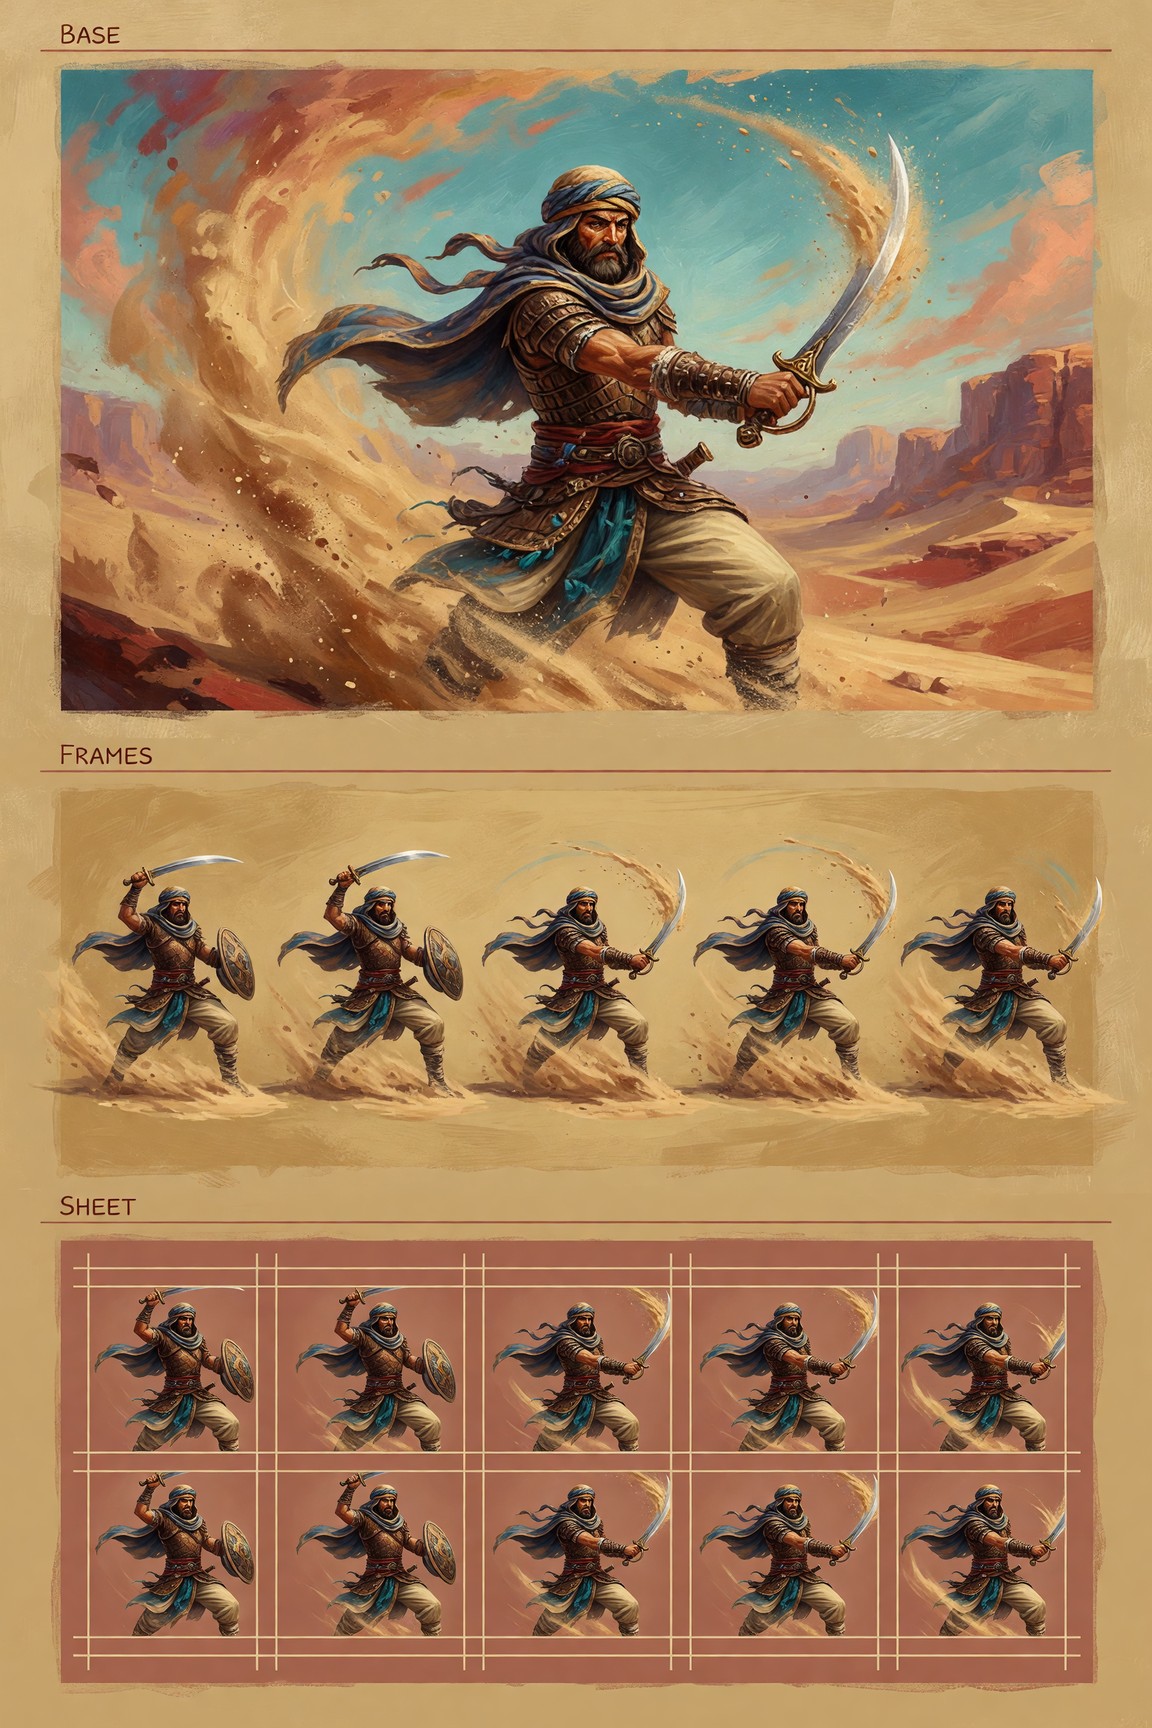
Was offizielle Beispiele zeigen — und was nicht
Die X-AI-Galerie zeigt Typografie, Bearbeitung, mehrere Referenzen, Smart Resize und Character Sprite und hilft beim Entwurf von Testkategorien. Es sind ausgewählte Anbieterbeispiele, keine durchschnittliche Erfolgsquote. Teste normale Prompts, schwierige Formate, wiederkehrende Figuren, kleine lokalisierte Texte, Transparenz und Bearbeitungen mit unveränderten Außenbereichen in tatsächlicher Spielgröße.
Ein reproduzierbarer Modelltest
Teste echte Lieferaufgaben: neue Figur, dieselbe Figur in einer zweiten Szene, lokale Kleidungsänderung, texttragende UI, Objekttafel und Breitenerweiterung. Verberge den Anbieter, mische die Reihenfolge und bewerte Anweisungen, Komposition, Text, Identität, Bearbeitungstreue, Fehler und Nacharbeit getrennt. Das Ergebnis ist eine Routing-Regel pro Aufgabe, kein universeller Sieger.
- Prompts, Referenzen, verfügbare Seeds und Abnahmekriterien fixieren.
- Mit low beginnen und nur geeignete Kandidaten auf medium erhöhen.
- Zurückgegebenes Modell, usage.cost_in_usd_ticks, Latenz und Wiederholungen protokollieren.
- Text, Figurenidentität, lokale Bearbeitung, Formate und Fünf-Bild-Komposition getrennt prüfen.
- Preise und Arena bei Veröffentlichung, Einkauf und großen Updates erneut prüfen.
Eine Qualitätsstrategie statt eines dauerhaften Siegers wählen
Nutze low für breite Exploration, medium für wenige detail- oder bearbeitungssensible Aufgaben und explizite Einstellungen für vergleichbare Budgets und Regressionen. Wechsle vor dem 2. November ausdrücklich zu 2.0, prüfe das zurückgegebene Modell und vergleiche Kosten pro akzeptiertem Ergebnis. Arena und Beispiele grenzen Tests ein; die reproduzierbare interne Auswertung entscheidet über Produktion. Dokumentiere außerdem, wer einen Kandidaten freigibt, welche Fehler eine automatische Ablehnung auslösen und welche Bearbeitungen noch manuell zulässig sind. Wiederhole denselben Testsatz nach Preisänderungen, Modellaktualisierungen oder auffälligen Qualitätsverschiebungen. So bleibt die Entscheidung nachvollziehbar, und ein guter Rang wird nicht versehentlich mit zuverlässiger Produktionsleistung gleichgesetzt.
Häufig gestellte Fragen
Umstieg auf Grok Imagine Image 2.0: Qualität und Kosten
Geprüfter Leitfaden zu low, medium, auto, Bildpreisen, Migration und Arena-Belegen.
Auto
Der alte quality-Modellname endet am 2. November 2026 und wird auf Image 2.0 low geleitet.
Arena
Der von X AI zitierte Arena-Rang ist eine Momentaufnahme vom 7. August 2026. Identität, Text und Bearbeitungstreue müssen mit eigenen Prompts geprüft werden.
Sollte ich low oder medium verwenden?
Nutze low für Komposition und Richtung; erhöhe Kandidaten auf medium, wenn Text, Gesichter, Details oder Bearbeitungstreue über die Freigabe entscheiden.
Was sollte ein Migrationstest messen?
Anweisungsbefolgung, Identität, Text, Bearbeitungstreue, Fehler, Latenz, Wiederholungen, Prüfzeit und Kosten pro freigegebenem Asset.
Zeigen offizielle Beispiele die Durchschnittsqualität?
Nein. Sie zeigen die Produktabsicht und helfen bei der Testplanung, sind aber ausgewählte Ausgaben ohne zufällige Erfolgs- oder Fehlerquote.
Quellen und weiterführende Literatur
- X AI Image 2.0 migration guide
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
- X AI Grok Imagine Image 2.0 model page
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
- X AI API pricing
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
- X AI Imagine Image 2.0 launch
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
- X AI cost tracking
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
- Arena Text-to-Image leaderboard
Offizielle Quelle, am 20. September 2026 für Funktionen, Preise, Migration oder Spielmodi geprüft.
Nächster Schritt